
一句话先给结论:MoE 模型里,数学和代码这些本事并不住在几个固定的「专家」里,而是散落在跨专家的零散神经元上。所以剪枝的正确单位不是部门,是工位。
一句话
腾讯研究团队在论文里给了一个反直觉的结论:混合专家模型(MoE)的能力分布,比我们以为的碎得多。你没法指着某几个专家说「这就是数学专家」。
划重点:技能不是以「专家」为单位存起来的,而是以「神经元」为单位、跨专家分布的。这句话决定了后面所有剪枝策略的对错——单位选错,后面怎么调参都是白费。
说白了,行业里过去那种「一个专家负责一类活」的直觉,至少在这两类技能上站不住。专家是路由分出来的容器,不是能力本身。
以前是裁专家,现在是裁神经元
按整个专家剪枝,是过去最省事的做法:哪个专家在路由里拿到低分,就把整个专家删掉。显存省得多,工程上也最好实现。
问题在于,如果技能散在专家内部的神经元上,删掉一整个专家就等于连带删掉它内部那些还有用的神经元。据腾讯研究团队论文,这种剪法会误伤技能,掉的性能比预期多。
换个单位:只删每个专家内部最没用的神经元,专家的壳保留,骨干留着。同样是压缩模型,能力掉得少很多。这是 RAMP 的核心动作,也是它跟老办法最本质的差别。
一个类比:MoE 像一家分部门的大公司。以前以为砍成本要裁掉整个部门,结果发现每个部门里都有一批摸鱼岗位。精准裁掉摸鱼的、留下骨干,公司照常运转。
RAMP 怎么打分:看路由贡献
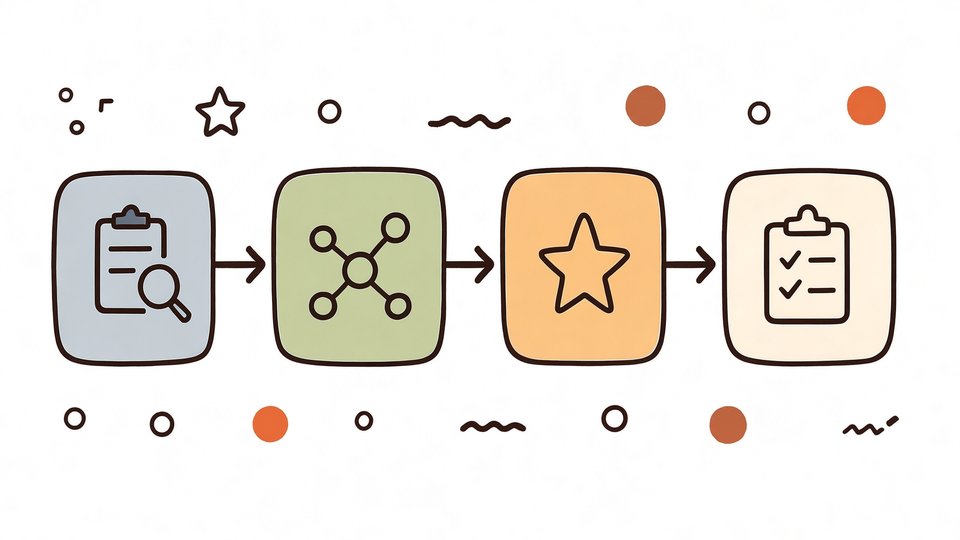
剪神经元的前提,是你得知道哪个神经元没用。RAMP 的打分依据是「路由贡献」——这个神经元对路由决策、对任务输出的实际影响有多大。
划重点:不是看权重大小,也不是看激活频率。权重小但每次都被路由选中、真在影响输出的神经元,剪了就是硬伤。这套标准看的是「干了多少活」,不是「占了多大地方」。
打完分从低到高排,按比例剪尾部。论文里给了 25% 和 50% 两个档位。颗粒度细是优点,代价是每个专家都要单独算一遍分。
我的看法:这套方法最贵的地方不在剪,在算。要给每个神经元算贡献,得先拿校准数据跑一遍。论文的实验规模里这笔开销可以接受,落到千亿参数、几十个专家的真实模型上,成本得另算——论文没给这个数。
数字摆在桌上:91% 和 36%
据腾讯研究团队论文,剪掉最无用的 25% 神经元,6 个模型仍保留 91% 至 98% 的性能。这个区间的下限值得盯:91% 意味着有小一成的能力是真的掉了。
再往上剪,剪掉 50% 神经元时,GPU 显存下降 36% 至 43%,批量 prefill 吞吐提升 17% 至 39%。这两组数是这篇论文最有说服力的部分。
但两个数字放一起得算一笔账:神经元少了一半,显存只降了三到四成。为什么不是对半砍?因为 MoE 的显存大头还有别的部分,专家之外的参数、激活、缓存都占着。神经元剪一半,省下来的是抽成,不是全额。
吞吐的最低值 17%,出现在最差的那个模型上。据论文口径这是批量 prefill 场景,也就是长输入一次性灌进去。单条对话、小批量的场景,收益未必有这么多,这点读论文时容易被忽略。
我的判断:这刀能省到什么程度
先说我的判断:这项工作真正的价值不在「剪一半还能用」,而在「剪枝的单位选对了」。单位错了,再漂亮的调参也救不回来,这一点比 91% 那个数字重要。
第二个判断:91% 到 98% 这个区间太宽了,说明不同模型、不同任务对神经元剪枝的耐受度差别很大。落到具体业务,你得先测自己那类任务落在哪一头。要是正好在 91% 那头,某些能力可能掉得肉眼可见。
但这里有个前提:论文测的是数学、代码这类技能。换成需要长链推理、需要精确记住事实的任务,散在神经元里的知识被剪掉 50%,掉的可能不是几个点,是断崖。论文没回答这个问题。
所以这刀能省到什么程度?省显存是真的,省下的比例要看模型结构;保能力也是真的,但保的是「大部分」,不是「全部」。真要用在生产上,先拿自己的评测集跑一遍 25% 档,再决定要不要往 50% 走。别拿论文的最优值当自己的基线。

