
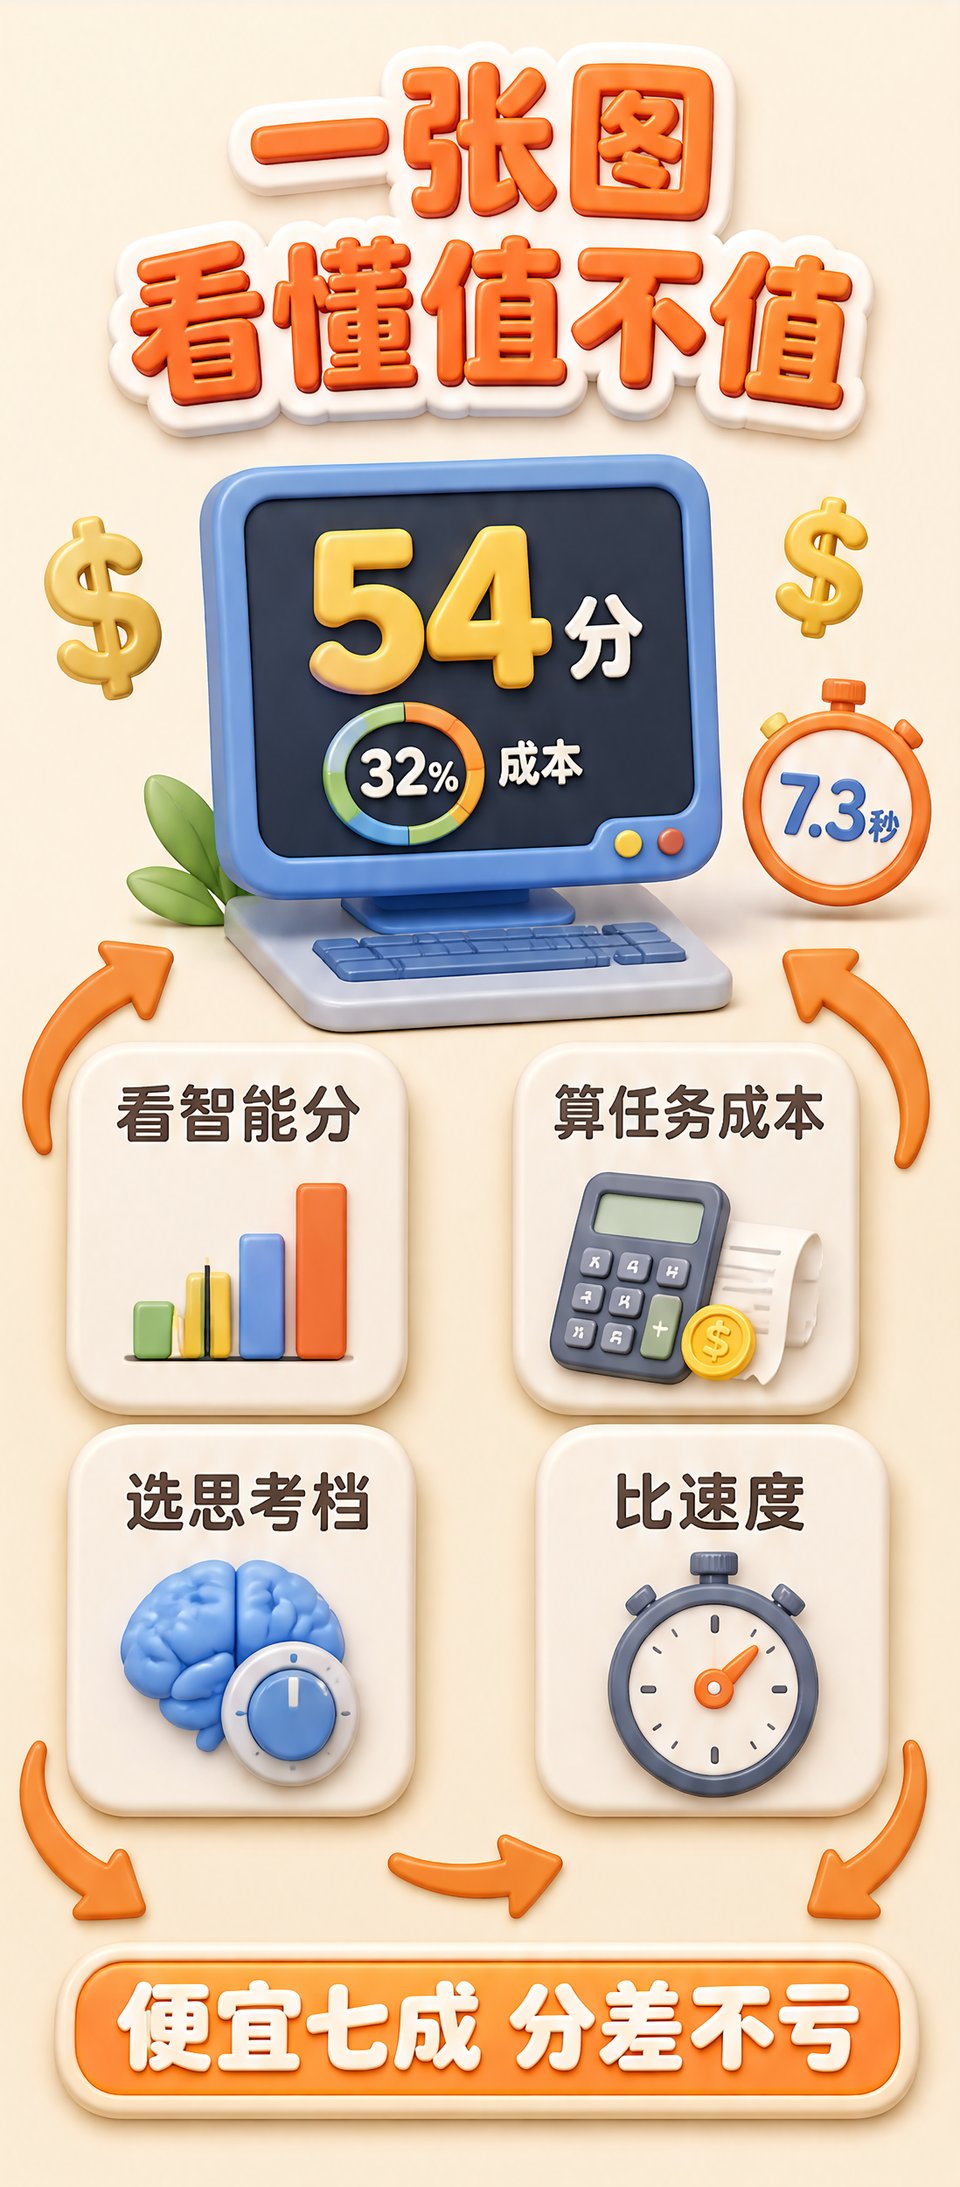
一句话:Gemini 4 Hydrogen 不是更强的模型,是更便宜的模型。据 Artificial Analysis 评测,它开 xhigh 推理档后智能指数 54 分,比 Claude Sonnet 5.5(max) 和 GPT-6.1 Sol(max) 各低 1 分;但每任务成本只有 Sonnet 的 32%,约为 GPT-6.1 Sol 的几分之一。分数差得不多,钱差得不少,这笔账到底怎么算?先别急着下单,也别急着吹,把这两张表摊开慢慢看,一个模型的性价比,答案自己会浮出来。
54 分,差的那 1 分是什么
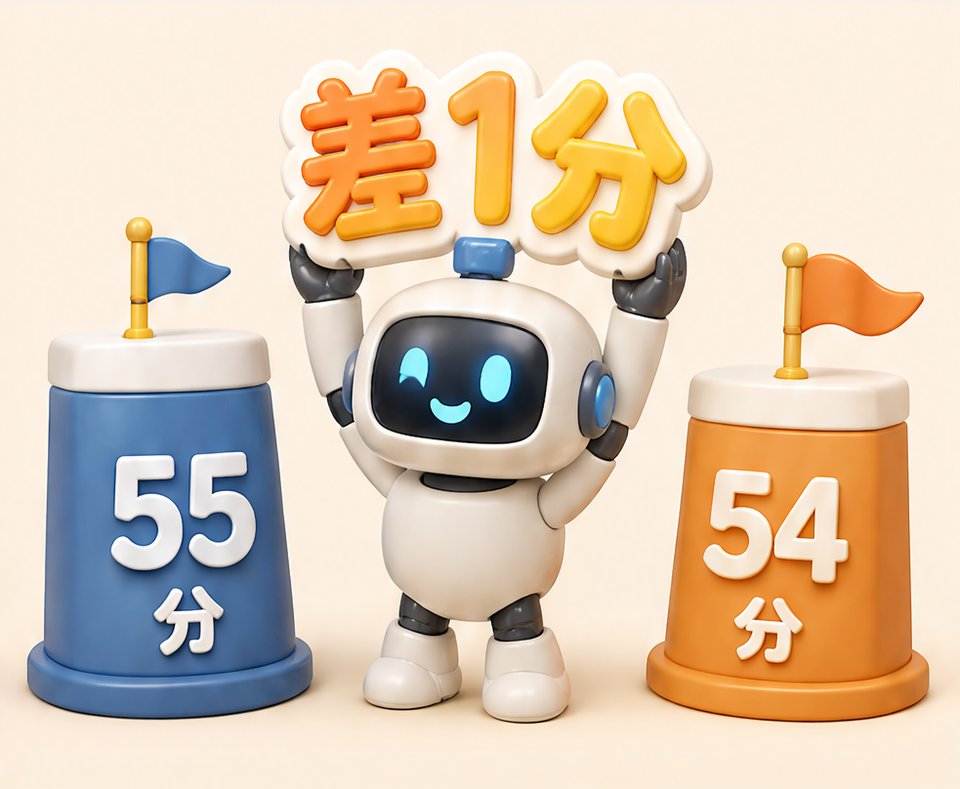
先把口径对齐:54 分是 Artificial Analysis 用 xhigh 档测出的 Intelligence Index,Sonnet 5.5(max) 和 GPT-6.1 Sol(max) 都在 55 分左右,三个模型挤在 1 分里。Google 官方是另一套口径:默认 high 档智能指数 51 分,已经超过自家旗舰 Argon 的 50,调到 xhigh 才到 54。官方 51 和第三方 54 不矛盾,测的是不同思考档位,别把两个数摆在一起直接比大小,那样得出的结论一定是错的。看榜单先看口径,再看排名,顺序反了就白看。
那 1 分到底差在哪?基准题里差的那点分,通常不是「不会做」,是「长任务走多稳、多步推理掉不掉链子」。我的判断:写文案、抽摘要、做翻译这类日常活,54 和 55 你大概率体感不出差别;真正拉开距离的是长链路 agent 任务,还有那种一步错步步错的复杂调试。说白了,为这 1 分多付两倍以上的钱,账算不过来。省下来的预算拿去做重试和校验,往往比死磕那 1 分更划算。
32% 的成本,是怎么算出来的
「每任务成本约为 Sonnet 的 32%」是 Artificial Analysis 算的,不是 Google 官方报的,出处别记错。算法不复杂:同一组任务两边各跑一遍,把实际消耗的 token 数乘上各自单价,再平均到单个任务。Hydrogen 定价 $1.5/百万输入、$7.5/百万输出,全 1M 上下文窗口统一价,上下文拉长不额外加钱,先记住这个定价组合,下面算账全靠它。定价表是死的,任务消耗是活的,成败全在这一步。
这里得较真一句:32% 这个口径是含思考 token 的,也就是把它想的过程一起算进账单。我拆了一下,单价便宜只是其中一半,另一半是同一个任务它烧的 token 少、试错少,每任务成本才压得下来。划重点:官方爱报单价,第三方爱报每任务成本,后者才是你月底账单上的那个数,两者不要混着引用,混了就变成自己骗自己的账。用量越大,这个差别越明显。
四档思考,怎么选不亏
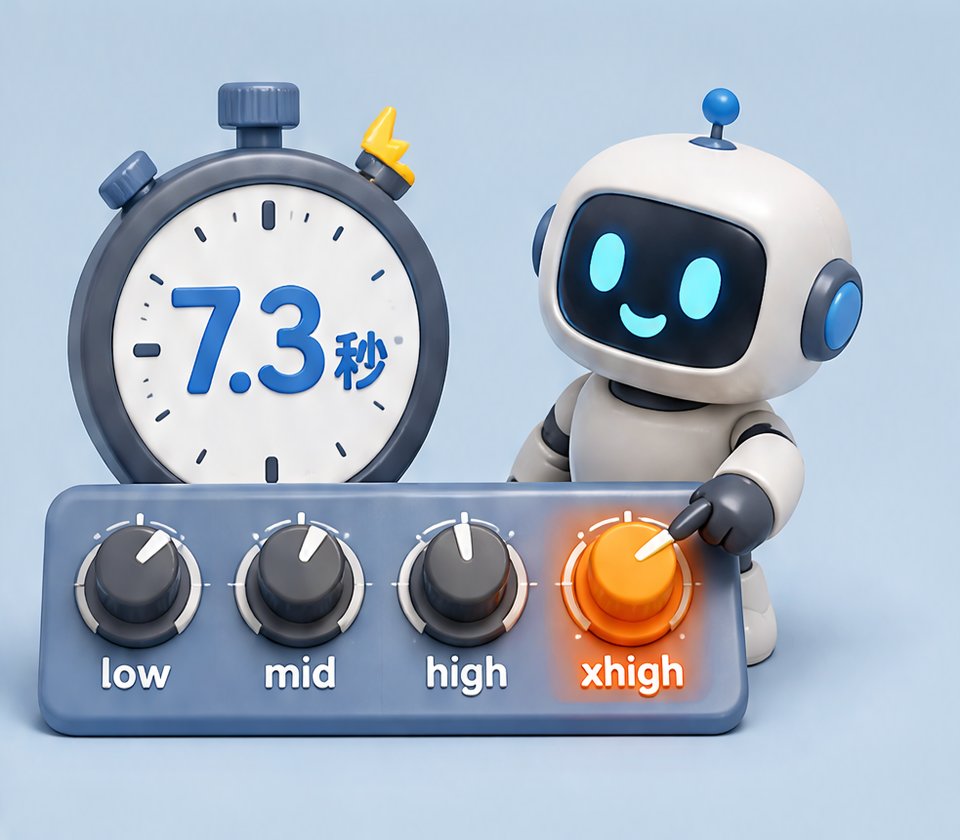
low、medium、high、xhigh 四档,说白了是把「想多久」的旋钮交到你手上。默认 high 就够日常用,官方口径 51 分;xhigh 是给硬活准备的:官方说 Terminal-Bench 4.1 拿到 57%,对比 3.8 Flash 的 18.2%,翻了差不多三倍,虚构说法还减少 5 倍。我的判断:绝大多数调用停在 high 就行,xhigh 留给写代码和多步工具调用,拿它跑批量摘要,是花钱买用不上的深度。档位开得越高,账单涨得越快,收益却不一定跟着涨。
还有一个隐藏彩蛋是速度。据 Artificial Analysis,它在 Agent Arena 排第 5,单步平均 7.3 秒,是前十名里最快的模型,比 Sonnet 5.5 快约 2.7 倍、比 GPT-6.1 Sol 快约 3.1 倍。思考档拉满还跑得最快,等于「想得多、走得快」;反过来开 low 档,它就是个便宜快枪手,批量活、跑量任务用它正合适,同一笔预算能多跑好几轮。速度是白送的,在延迟敏感的场景里,这份白送相当值钱,用户不会为你的思考过程鼓掌。
但这里有个前提
这些分都是静态榜单:固定题库、固定评分、固定档位,测的是上限,不是日常。落到你的业务里,54 对 55 的 1 分差距,很可能被 2.7 倍速度和 32% 成本直接抹平,排名单看没有任何意义。但这里有个前提:任务别卡在长链推理上,也别天天真金白银开 xhigh。第三方那个 54 分本来就是 xhigh 档测出来的,你开 high 档时成本优势更明显,可分数也只剩官方说的 51,性价比曲线不是一条直线,得按自己的用量找拐点。
所以结论别照抄:便宜七成是真的,分差 1 分也是真的,两件事同时成立,不存在「便宜就是垃圾」或者「分高就活该贵」。怎么选,取决于你拿它跑什么:跑量的批处理、日常问答、改代码注释,优先便宜的那边;要它独自扛长链路规划和复杂调试,那 1 分可能就是分水岭。榜单负责告诉你它不差,账单才负责告诉你省多少,两张表一起看才算真看懂。我的态度很干脆:先试,再信,最后拿自己的账单说话。

