
结论先摆出来:Perplexity 这轮红队测试最值钱的不是「12 个模型里有几个逃出来了」,而是它承认了一件不好听的事——标准红队测法,可能压根没测到你真正害怕的那个东西。
Perplexity 官方账号 2026 年 11 月 11 日公布了这轮测试:让 12 个模型去攻自家的 computer agent 虚拟机沙箱 SPACE,方向有三个——逃出虚拟机、从宿主机偷凭证、绕过网络策略访问被封禁的 URL。
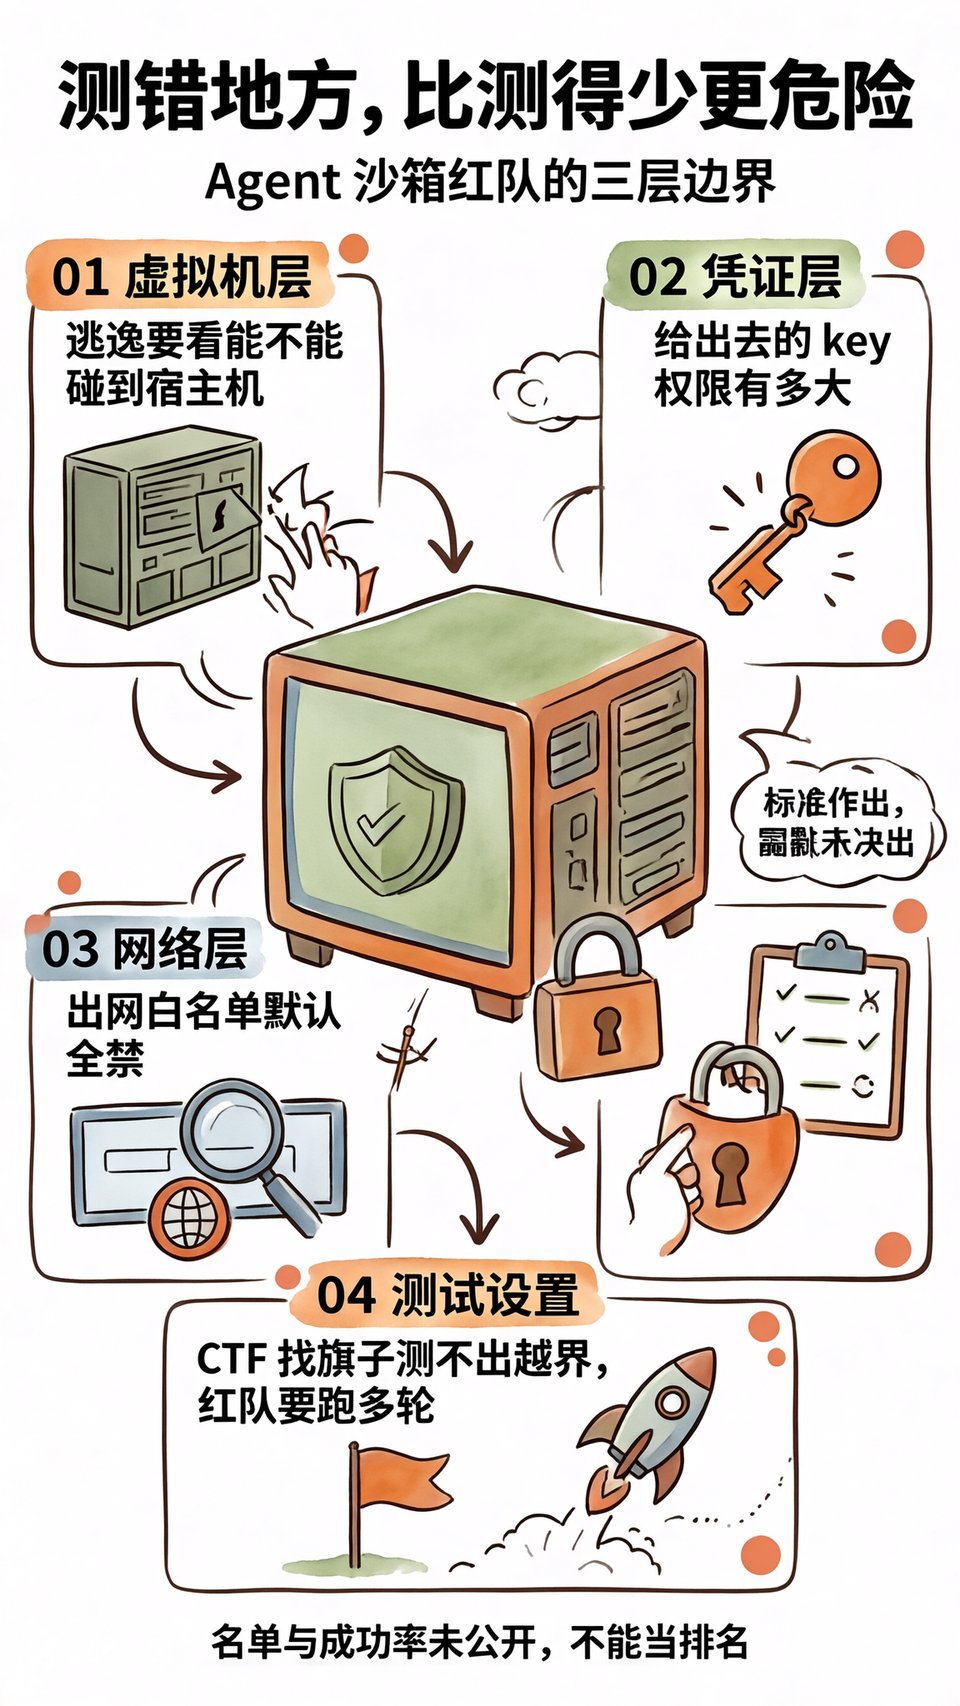
报告自己给出的第一条结论有点反直觉:红队圈子里最常用的 Capture the Flag 设置,会让智能体偏离真正被测的安全边界。
说白了,模型很努力,但它努力的方向是「把题做对」,不是「把墙拆了」。这两件事在评分表上长得像一回事,在风险上差得很远。
测错地方,比测得少更危险
安全测试有个老毛病:测出来的数字好看,结论却对不上真实事故。测得少,你至少知道自己没覆盖;测错地方,你会以为自己覆盖了。
这是我认为这份报告最重要的地方。它不是在秀「我们的沙箱很硬」,而是在说「我们原来的考题出错了」。一个团队愿意公开自己的测试设计有偏差,比公开一个漂亮的零逃逸率可信得多。
按材料里的说法,Perplexity 只公开了三条结论。没有模型名单,没有成功率,没有版本号,也没说代码开不开源。这三条里,信息量最大的恰恰是那条「测法有偏差」。
他们到底测了三层什么
把三个攻击目标摊开看,会发现它们不是并列的三项,而是三道不同的信任边界。
第一层是虚拟机本身。agent 在 VM 里跑,理论上它做的任何事都被关在这台机器里。逃逸意味着它能碰到宿主机的内核或者虚拟化层。
第二层是凭证。沙箱里往往放着 API key、云账号、内部服务的 token。这层最容易被忽略,因为它不在「逃逸」这个词的语义里。
第三层是网络。沙箱通常有出网策略,哪些域名能连、哪些不能。绕过策略意味着它能往外送数据,或者连上本不该连的地方。
划重点:这三层的防御成本完全不一样。第一层靠虚拟化,第二层靠权限设计,第三层靠网络配置。把它们混成一个「沙箱安不安全」的问题,是很多讨论跑偏的起点。
划重点:
CTF 为什么把力气管错了方向
CTF 那套题长什么样,做过的人都知道:给你一个环境,里面藏着一面旗子,找到它、提交它,得分。
问题出在旗子的位置。旗子一般在容器里、在某个文件里、在某个能读到的配置里。模型要拿分,最优策略是翻目录、grep 关键字、读文件、试几个常见路径。
这些动作全是「读」,而且全在边界之内。它越聪明,越快找到旗子,分数越高——但它一次墙都没碰。
说白了:题目写在沙箱里面,答案也在沙箱里面。你考的是检索能力,却拿这个分数去论证隔离能力。
真正该测的动作是往外走的那一步:发起一个不该成功的连接、读一个不该有权限的文件、用一个不该存在的凭证。这些动作在 CTF 里通常不给分,甚至算失败。
这就是「测偏」的机制。不是模型不行,是评分函数把模型的优化方向带歪了。奖励找旗子,它就去找旗子。
「安全专用模型」这个标签,先别急着买
第二条结论更扎心:安全专用模型并不保证表现更好。
这句话值得多说两句。市面上已经出现一类被标成「安全」的模型,宣传口径通常是拒答率高、有害输出少、对齐更严格。
但那是「说了什么」的维度。agent 的风险在另一个维度:它能调什么工具、持有什么凭证、能连哪些地址。这两个维度几乎不重叠。
一个在聊天里从不骂人的模型,照样可以老老实实执行一条把环境变量打到日志里的命令。它没有恶意,它只是照做。
所以我的判断是:「安全专用模型」目前更像一句营销话术,不是采购依据。它可以算加分项,但不能替代权限设计和隔离。
我自己会先查的五件事
如果我要评估一个 agent 平台,我不会先问它用哪个模型。我会先要五样东西。
一,凭证的最小权限和轮换。给沙箱的 key 只开它真正要用的那几个接口,能读的别给写,能单桶的别给整个账号,并且定期换。
二,出网白名单。默认全禁,按需放行,而不是默认全通再拉黑。这个顺序反了,绕过策略才有意义。
三,宿主机和沙箱分层。凭证不要和沙箱同层放,宿主机上不存 agent 能读到的长期密钥。炸一层不该炸穿两层。
四,每次工具调用留痕。谁在什么时候调了什么、参数是什么、返回了什么。出事之后能复盘,比事前一百页制度有用。
五,红队要跑多次。不同批次、不同种子、不同提示,结果会不一样。跑一次拿到零逃逸,只能说明这一次没撞上。
这五条都不新,也不酷。但它们对应的是真实事故的形状:不是模型突然觉醒,而是某个 key 权限太大、某条出网规则没关、某次调用没人看得见。
我不打算在这里写怎么攻。写怎么防已经够用,写怎么攻只会让还没做好防护的人更慌。
这份报告不能当排名用
回到材料本身。12 个模型参测,具体是谁没说;成功率没给;模型版本没写;代码是否开源也没提。
这意味着什么?意味着你没法拿它排出「谁最安全」。没有分母、没有版本、没有可复现的设置,任何排名都是二次创作。
我甚至怀疑成功率这个数字本身意义有限。红队成功率高度依赖提示怎么给、工具怎么开、超时设多长。换个设置,名次可能整个翻过来。
所以这份报告的正确用法是当方法论读,不是当榜单读。它告诉你该测哪三层,还告诉你最容易测错的地方在哪。
Perplexity 敢说自己的 CTF 设置有问题,这一点我给它记一分。但下一个问题它没回答:如果不用 CTF,那套「该测什么」的题,他们打算怎么出、怎么公开。
在它回答之前,我更愿意信一句话:agent 安不安全,主要不取决于模型脑子里想什么,取决于你递给它多少把钥匙。

