
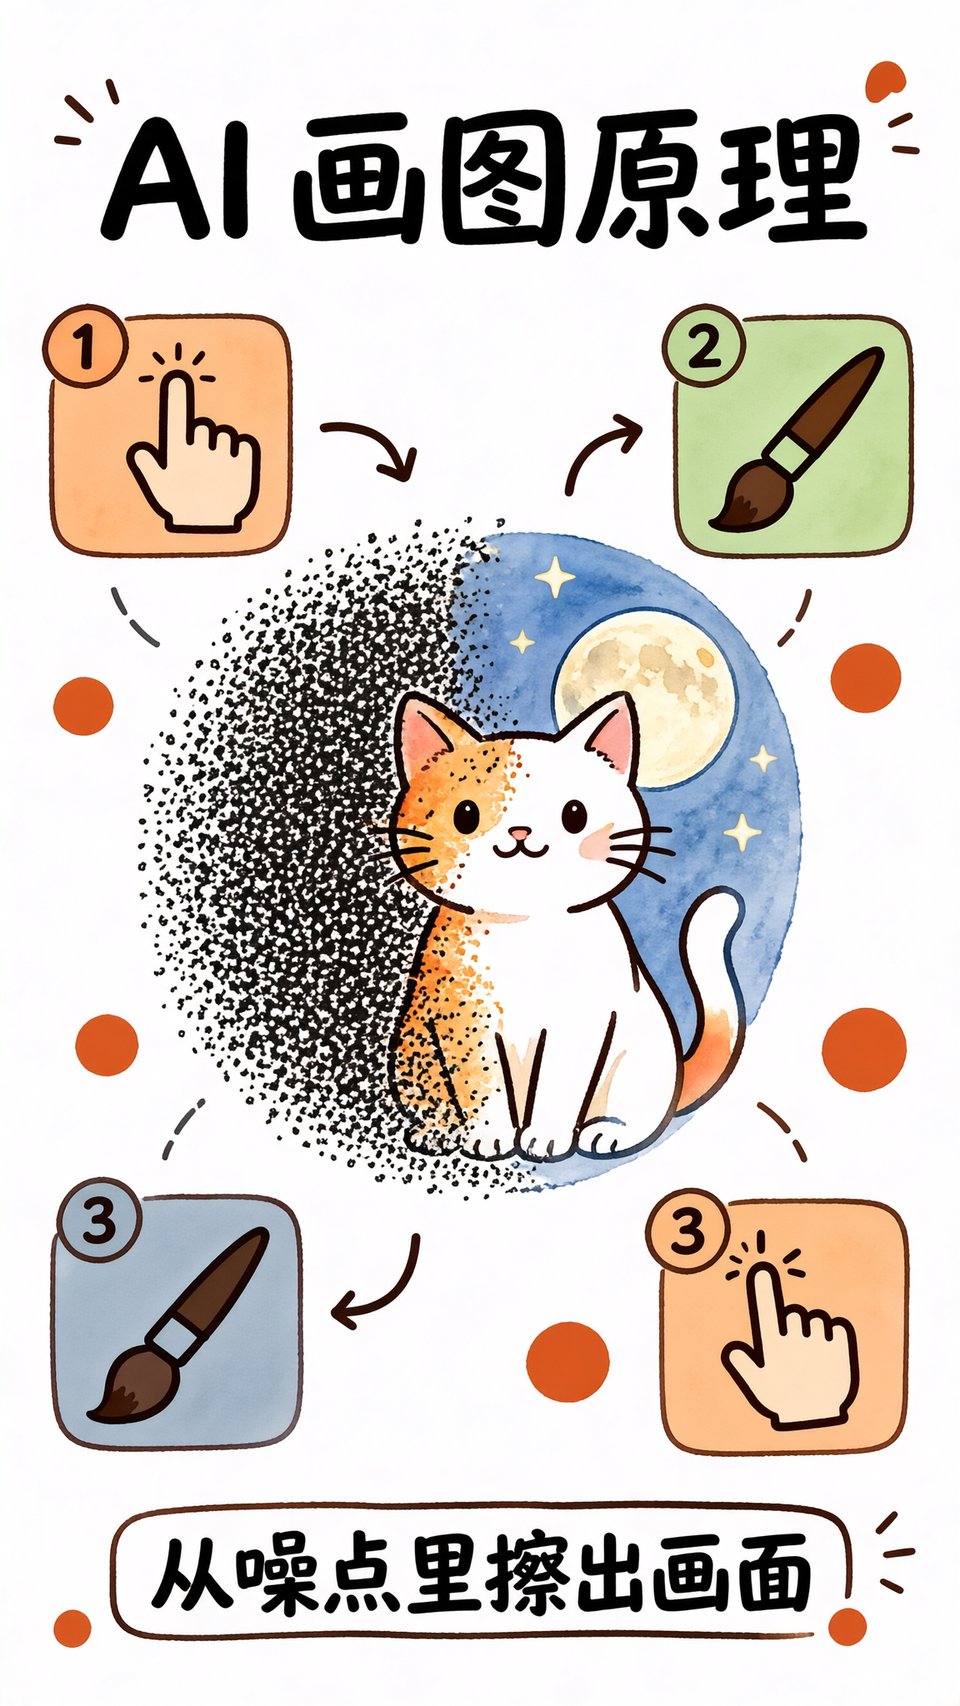
你在输入框打一句"一只猫在月球上喝茶",十几秒后出来一张图。
它不是上网找的,也不是照某张画临摹的。它是从一堆随机噪点里,"擦"出来的。
扩散模型:先教它认「噪点」,再教它「去噪」
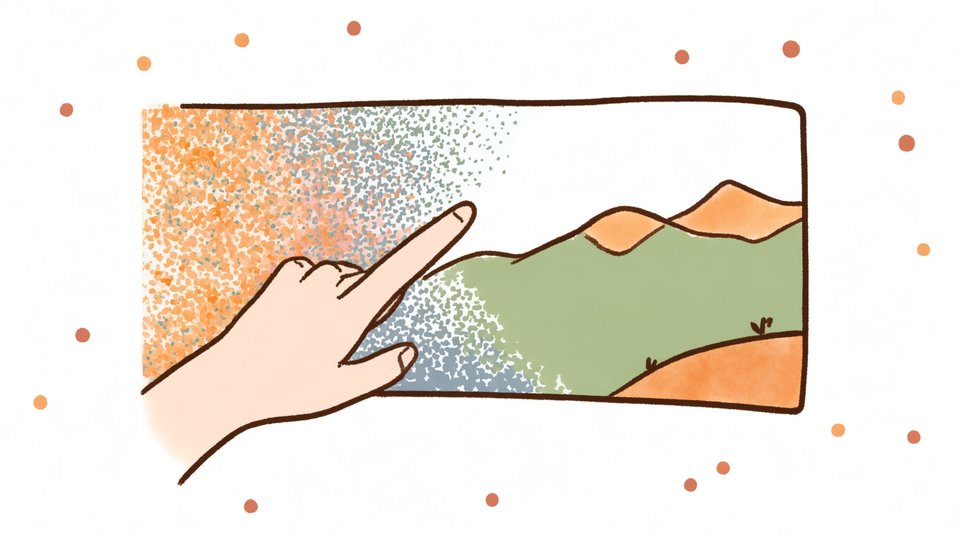
这套方法叫扩散(Diffusion),原理分两步:
第一步,加噪。拿一张清晰的图,一点点往上加随机噪点,加几百次,图就变成一片雪花。这个过程记录下来,就知道"从清晰到模糊"每一步是什么样。
第二步,学反向。训练模型,让它学会反过来——看到一片雪花,猜出"上一步稍微清晰一点的样子"。一次猜一步,猜几百步,雪花就慢慢还原成一张清晰的图。
训练完成后,你给它的不是雪花,是纯随机的噪点。它一步步去噪,最后"擦"出一张从没存在过的图。
为什么能听懂你的话
关键在于每一步去噪时,都带着你的文字提示一起判断。
"猫"这个条件,会让它把某些区域的形状往猫的方向修;"月球"会让背景往灰白、坑洼的方向修。
所以文字描述越具体,它每一步的判断越有依据,出来的图越贴近你的想象。
为什么手总是画歪
这是最经典的翻车点。
原因很实在:训练数据里,手出现的次数、姿态的多样性,远不如脸和身体。它见的手不够多,去噪时就在"手指头"这个区域举棋不定,最后糊成一团。
同理,这几样也容易出错:文字、精细结构、多个物体的正确关系、物理常识。它不知道"杯子放在桌上要有支撑",它只知道"这种画面通常长什么样"。
提示词怎么写得更好
它不是理解语义,是匹配画面特征。所以:
说具体的名词和视觉元素,别说抽象情绪。"温暖的氛围"不如"夕阳、暖黄色光、木质桌面"。
说清风格。水彩、油画、皮克斯 3D、扁平插画——这个词比十个形容词管用。
说清构图和镜头。特写、全景、俯视、逆光。
加负面词。不想出现的(模糊、多余的手指、文字),单独列出来让它避开。
现在能拿它做什么
用到位的话,这些活它已经很好用:
- 公众号配图、文章插图;
- 电商主图底图、场景图;
- 短视频封面、空镜素材;
- 灵感草图、方案概念图。
拿它做"最终成品"要小心的地方:出现真人肖像(涉及肖像权)、出现品牌标志(涉及商标)、需要精确文字的设计(它写中文还是容易错)。
一句话带走
它不是画,是从噪点里擦。
懂了这点你就明白:为什么具体描述有用、为什么手会画歪、为什么它不擅长精确文字。
下一篇:AI 生成视频,现在到底能用到什么程度。
